Do Chat ao Agente: comece a construir um agente de IA com R
Do conceito ao código: LLMs, tool calling, system prompt, memória e produção com o pacote ellmer
Por onde começo
Pessoal, quando comecei a estudar agentes de IA em R, a primeira dificuldade não foi exatamente no código. Foi entender o que diferencia um agente de um chat comum, aquele que a gente abre e conversa.
Então vocês vão me perguntar, mass qual a diferença Jeny?
Um chat comum, como o que você usa no navegador, responde com o que aprendeu durante o treinamento. Ele não tem acesso aos seus dados, não executa funções, não consulta tabelas. Quando a pergunta exige um dado que ele não possui, ele completa com o que parece mais provável, mesmo que seja falso.
Um agente resolve esse problema conectando o modelo de linguagem a ferramentas externas. Antes de responder, o modelo detecta que precisa de um dado, solicita a execução de uma função R, recebe o resultado e formula a resposta com base nesse dado verdadeiro.
Eu usei essa abordagem em um projeto comercial da Assimétrika. O que eu desenvolvi para o meu cliente, foi muito além do tutorial de hoje. Mas para você começar, esse tutorial é uma porta de entrada.
Para hoje
Trouxe um exemplo, no qual o resultado foi criar um agente que responde com precisão sobre valores, prazos e prioridades de follow-up, sem inventar nenhuma informação. Ao longo deste post, vou mostrar todos os conceitos envolvidos.
O que é Inteligência
Antes de falar de IA, é necessário definir o conceito que ela tenta replicar: a inteligência, gente isso me assusta ainda!
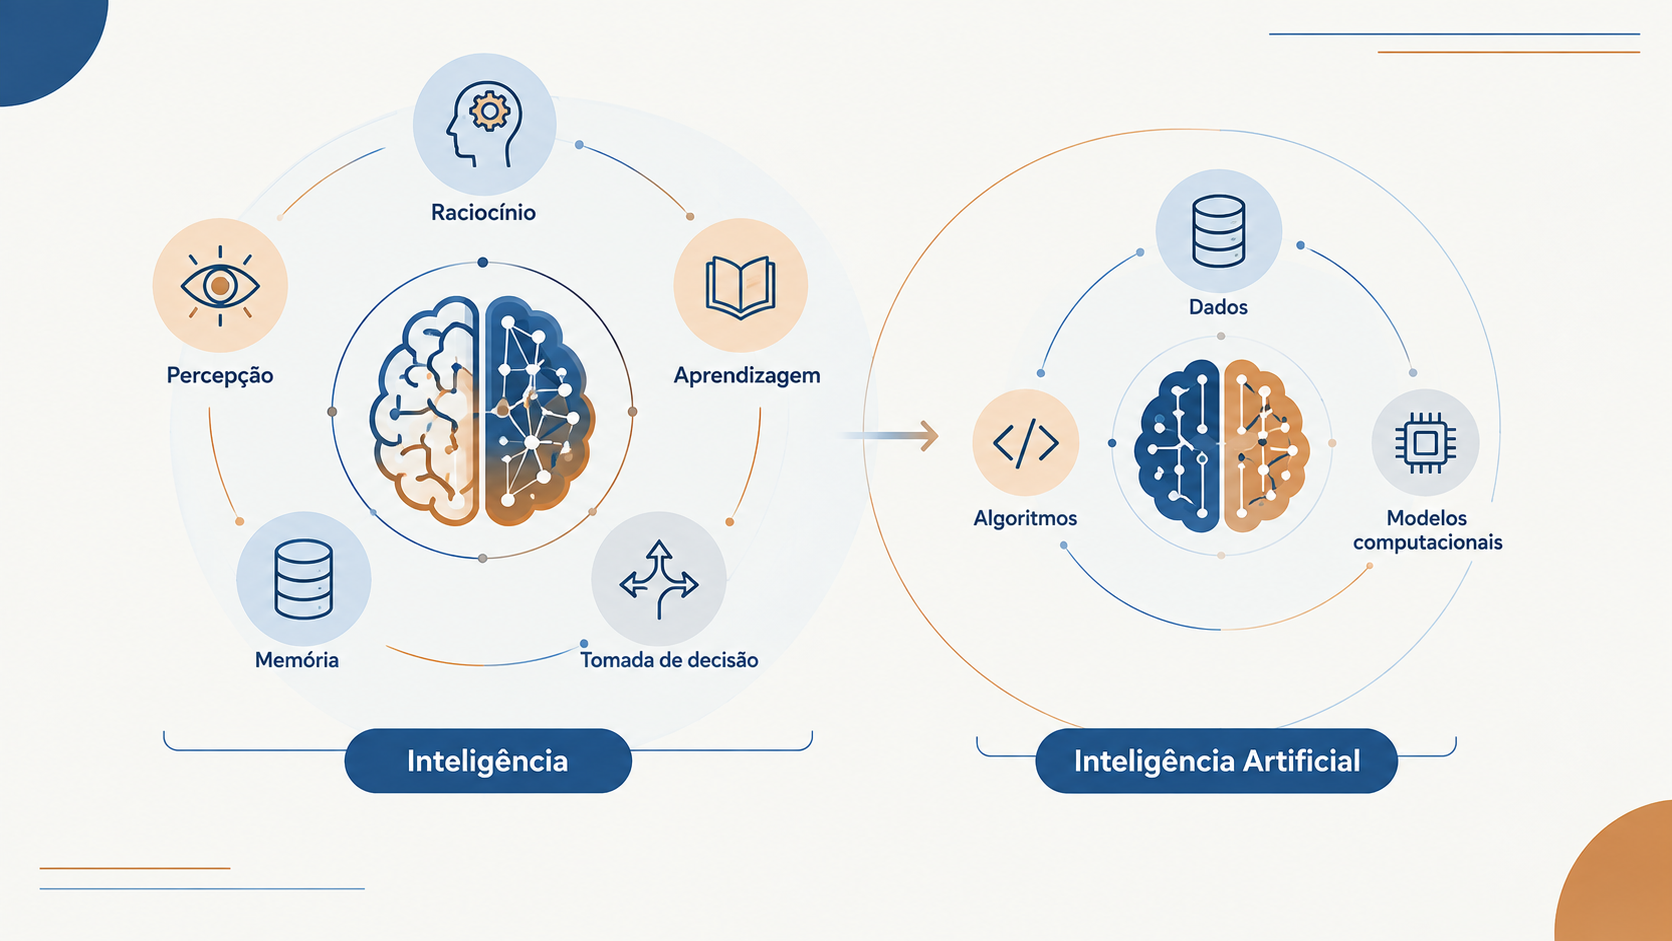
Inteligência é a capacidade de resolver problemas novos com base em experiência acumulada.
- Um ser humano que nunca viu um labirinto específico consegue encontrar a saída porque aplica raciocínio aprendido em outras situações: identificar becos sem saída, memorizar caminhos percorridos, testar alternativas sistematicamente.
Essa capacidade envolve três componentes centrais:
- Aprender com experiências anteriores;
- Adaptar o comportamento a situações novas e;
- Transferir conhecimento de um domínio para outro.
Um ponto importante, e frequentemente mal compreendido: quando dizemos que uma IA é “inteligente”, não estamos afirmando que ela raciocina como um ser humano.
Os modelos de linguagem modernos não possuem compreensão, intenção ou consciência.
Eles reconhecem padrões estatísticos em texto com uma escala que nenhum humano consegue igualar.
Essa distinção tem implicações práticas diretas para quem constrói e usa esses sistemas.
O que é Inteligência Artificial
Inteligência Artificial é o campo da computação que desenvolve sistemas capazes de realizar tarefas que, se executadas por humanos, exigiriam inteligência.
O termo foi cunhado em 1956 por John McCarthy durante a Conferência de Dartmouth, considerada o marco fundador da área. O que mudou nos últimos anos não foi o conceito, mas a escala dos dados disponíveis e o poder computacional para processá-los.
Exemplos que já fazem parte do cotidiano:
- Filtro de spam no e-mail: aprende a distinguir mensagens legítimas de indesejadas
- Recomendação em plataformas de streaming: aprende o que você assiste para sugerir o próximo conteúdo
- Reconhecimento de voz no celular: converte áudio em texto
- Detecção de fraude em transações bancárias: identifica padrões anômalos em tempo real
A IA é um campo amplo com várias subáreas. O diagrama abaixo organiza essa hierarquia:
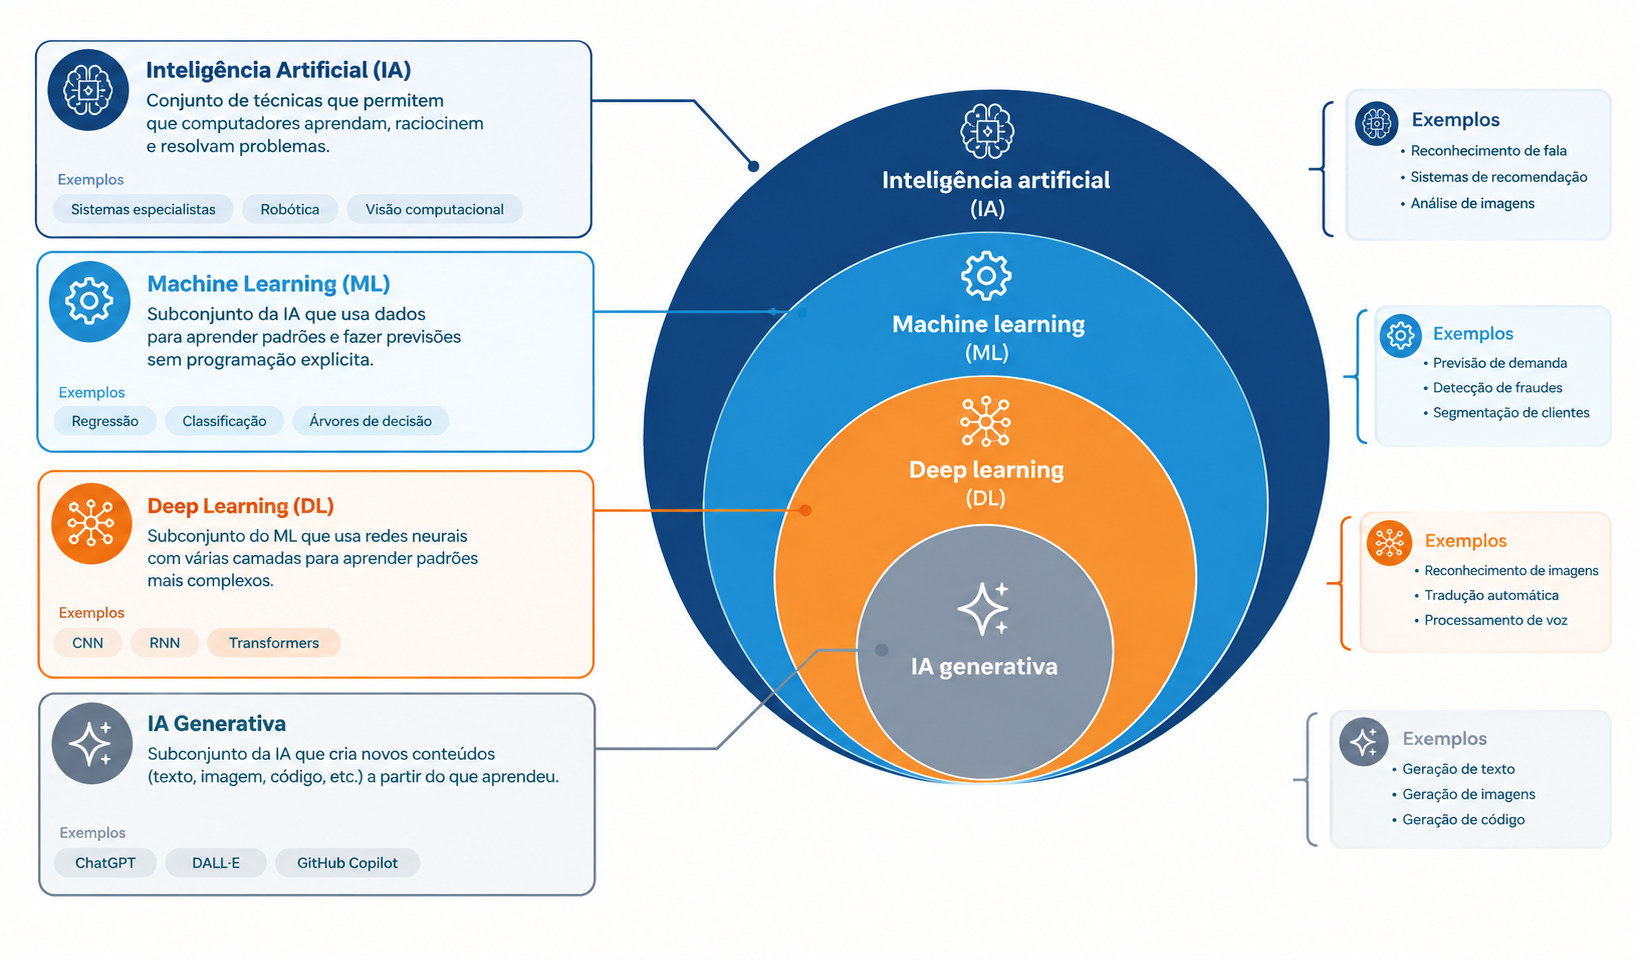
Machine Learning é a subárea em que os sistemas aprendem padrões a partir de dados, sem serem explicitamente programados para cada tarefa.
Deep Learning usa redes neurais profundas para aprender representações hierárquicas dos dados. Os Modelos de Linguagem de
Grande Escala (LLMs) são uma aplicação de Deep Learning especializada em texto. Os agentes de IA usam LLMs como motor de raciocínio e os conectam a ferramentas externas para executar ações reais.
O que é Inteligência Artificial Generativa
IA Generativa é a categoria de IA que produz conteúdo novo: texto, imagem, áudio, código, vídeo.
A diferença fundamental em relação às categorias anteriores de IA está na natureza da saída. Um sistema de classificação decide entre categorias existentes: esse e-mail é spam ou não é. Um sistema de recomendação seleciona entre itens existentes.
- A IA generativa cria algo que não existia antes.
| Tipo de saída | Exemplos de ferramentas |
|---|---|
| Texto | ChatGPT, Gemini, Claude |
| Imagem | DALL-E, Midjourney, Stable Diffusion |
| Código | GitHub Copilot, Cursor |
| Áudio | ElevenLabs, Suno |
| Vídeo | Sora, Runway |
Os LLMs, que são o foco deste post, pertencem à categoria de IA generativa de texto. Quando você digita uma pergunta no ChatGPT e recebe uma resposta, o modelo não está recuperando uma resposta pré-escrita de um banco de dados. Ele está gerando cada palavra da resposta em tempo real, token por token, com base nos padrões aprendidos durante o treinamento.
O que é um LLM
LLM significa Large Language Model, ou Modelo de Linguagem de Grande Escala. É um sistema treinado para processar e gerar texto. O treinamento ocorre em três etapas sequenciais.
Pré-treinamento: o modelo lê bilhões de páginas de texto da internet, livros, artigos científicos e código-fonte. Aprende padrões de linguagem: quais palavras aparecem juntas, como frases se estruturam, quais conceitos se relacionam. Não há supervisor humano nessa etapa. O objetivo é modelar a distribuição estatística do texto humano. Um modelo treinado dessa forma consegue completar textos, mas não necessariamente responde perguntas de forma útil.
Fine-tuning (ajuste fino): o modelo pré-treinado é ajustado com exemplos de conversas de alta qualidade, escritos ou avaliados por humanos. Nessa etapa, o modelo aprende a responder perguntas em vez de apenas completar texto, e a seguir instruções em vez de apenas continuar um padrão.
RLHF (Reinforcement Learning from Human Feedback): avaliadores humanos classificam pares de respostas do modelo, indicando qual é mais útil, precisa e segura. O modelo usa esse feedback para ajustar seus parâmetros, aprendendo a preferir o que os humanos consideram uma boa resposta. Essa etapa é responsável por grande parte do comportamento de “assistente” que percebemos nos modelos modernos.
O resultado desse processo é um arquivo com bilhões de parâmetros.
Um parâmetro é um valor numérico interno que o modelo ajustou durante o treinamento para representar padrões da linguagem. Um modelo com 120 bilhões de parâmetros não tem 120 bilhões de fatos memorados, ele tem 120 bilhões de pesos que, em conjunto, codificam os padrões do texto em que foi treinado.
O mecanismo de predição de tokens
O LLM NÃO raciocina. Ele prevê. Aqui é importante!!
Para cada posição no texto, o modelo calcula uma distribuição de probabilidade sobre todo o vocabulário, que pode ter dezenas de milhares de tokens, e seleciona o próximo token com base nessa distribuição.
Token é a unidade de processamento dos modelos de linguagem. Não é uma letra, não é uma palavra. É um fragmento de texto que o modelo aprendeu a reconhecer como unidade durante o treinamento.
# Exemplo de tokenização em português:
# Frase: "Quanto custa uma consultoria?"
# Tokens: ["Quanto", " custa", " uma", " consul", "toria", "?"]
# Total:  6 tokens
Em português, 1 token equivale a aproximadamente 3 a 4 caracteres. Uma palavra longa como “consultoria” pode virar 2 tokens.
Uma palavra curta como “uma” é 1 token. Provedores cobram por token processado, não por pergunta.
A janela de contexto, o limite do que o modelo processa em uma única chamada, também é medida em tokens.
# Verificar consumo de tokens da sessão atual:
token_usage()

# Verificar custo estimado do agente atual:
agente$get_cost()
Por que a mesma pergunta gera respostas diferentes
A temperatura é o parâmetro que controla a aleatoriedade na seleção do próximo token.
Matematicamente, o modelo produz um vetor de logits (pontuações brutas) sobre o vocabulário. A operação softmax converte esses logits em probabilidades. A temperatura divide os logits antes do softmax:
\[p_i = \frac{e^{z_i / T}}{\sum_j e^{z_j / T}}\]
onde \(T\) é a temperatura, \(z_i\) é o logit do token \(i\) e \(p_i\) é sua probabilidade após a transformação.
Com \(T \to 0\), o token mais provável recebe probabilidade próxima de 1 e os demais próxima de 0, respostas determinísticas e idênticas entre execuções.
Com \(T > 1\), as diferenças entre probabilidades se reduzem e o modelo passa a sortear com mais variação, gerando respostas diferentes para a mesma pergunta.
# Agente comercial: temperatura baixa
# Respostas consistentes e previsíveis entre execuções
agente_comercial <- chat_groq(
  model         = "openai/gpt-oss-120b",
  system_prompt = system_prompt_agente,
  params        = params(temperature = 0.2))

# Agente criativo: temperatura alta
# Respostas com variação intencional
agente_criativo <- chat_groq(
  model         = "openai/gpt-oss-120b",
  system_prompt = system_prompt_agente,
  params        = params(temperature = 0.9))
Para um agente que consulta dados verdadeiros e responde sobre preços e leads, temperatura baixa é a escolha correta. Respostas sobre valores de contrato precisam ser consistentes entre execuções.
Softmax é uma função de ativação usada principalmente em classificação multiclasse.
Ela transforma os valores produzidos pela rede neural em probabilidades que somam 1 (100%), indicando a chance de cada classe.
O que é alucinação
Alucinação é o comportamento em que o modelo gera informação factualmente incorreta com o mesmo nível de confiança com que gera informação correta.
É uma consequência direta do mecanismo de predição, isso porque o modelo não sabe o que sabe.
Ele prevê o que parece mais provável dado o contexto, e às vezes o que parece mais provável é factualmente errado.
Quando perguntado sobre o preço de um serviço que não está em seus dados de treinamento, o modelo não diz “não sei”. Ele gera um valor que parece plausível dado o contexto, que pode estar completamente errado.
Esse é o problema central que um agente bem construído resolve. Em vez de deixar o modelo adivinhar um preço, você fornece a tabela de preços como dado real via tool. O modelo não precisa “saber” o preço porque você fornece o preço antes da resposta ser formulada.
Os modelos que você pode usar gratuitamente para treinar e estudar
openai/gpt-oss-120b no Groq
Esse modelo tem 120 bilhões de parâmetros totais e usa uma arquitetura chamada Mixture of Experts (MoE).
Em vez de ativar todos os 120B parâmetros para cada token gerado, o modelo é dividido em 128 blocos especialistas.
Para cada token, um roteador seleciona apenas os especialistas mais relevantes para aquela tarefa específica, ativando aproximadamente 5,1 bilhões de parâmetros por vez.
O resultado: o modelo entrega a capacidade de raciocínio de um modelo de 120B com o custo computacional de um modelo de 5B.
gemini-flash-lite-latest no Google
O Gemini Flash foi construído com destilação de conhecimento, ou seja, os engenheiros extraem o conhecimento de um modelo maior e o compactam em um modelo menor, preservando capacidade e priorizando velocidade de resposta (baixa latência) e custo reduzido.
O número relevante nesse modelo é a janela de contexto de até 1 milhão de tokens, o equivalente a aproximadamente 750 mil palavras em uma única requisição.
Isso permite processar documentos longos, como contratos ou relatórios extensos, que travam modelos com janelas menores.
Eu uso o gemini-flash-lite-latest em vez do gemini-flash-latest em virtude de que o primeiro tem 30 requisições por minuto no tier gratuito, o segundo tem apenas 5. Em um ambiente com múltiplos usuários simultâneos, 5 requisições por minuto é insuficiente.
O pacote ellmer
O ellmer é o pacote R que conecta o código aos provedores de IA.
Ele gerencia autenticação, envio de mensagens, histórico da conversa, execução de tools e registro de tokens consumidos.
Foi desenvolvido pela equipe do tidyverse e segue os princípios de design do ecossistema, com uma interface consistente independentemente do provedor usado.
install.packages("ellmer")
install.packages("jsonlite")

library(ellmer)
library(jsonlite)- O
jsonliteé necessário para converter tabelas R para o formato JSON.
Um
data.framenão pode ser enviado diretamente ao modelo.O modelo recebe texto, e o JSON é a forma mais precisa de representar estruturas de dados em texto.
Uma função por provedor, mesma interface em todas:
# Groq: rápido, tier gratuito generoso (30 req/min)
chat_groq(model = "openai/gpt-oss-120b")

# Google Gemini: janela de contexto grande (1M tokens)
chat_google_gemini(model = "gemini-flash-lite-latest")

# Ollama: local, sem internet, sem custo por requisição
chat_ollama(model = "granite4.2:3b")

# Anthropic Claude: excelente para instruções longas e precisas
chat_anthropic(model = "claude-sonnet-5")
Trocar de provedor é trocar a função de criação.
O restante do código, as tools, o system prompt e o
$chat(), permanece idêntico.Essa independência de provedor é uma das principais vantagens de usar o
ellmerem vez de SDKs específicos de cada empresa.
O que o ellmer faz em cada chamada:
- Envia a pergunta ao provedor junto com o system prompt e o histórico completo
- Se o modelo solicitar uma tool, intercepta a solicitação e executa a função R correspondente
- Devolve o resultado da tool ao modelo como contexto adicional
- Recebe a resposta final e a retorna para o R
- Atualiza o histórico interno do objeto
chat - Registra os tokens consumidos e o custo estimado
Chave de API e .Renviron
Uma chave de API é um identificador único emitido pelo provedor para a sua conta. Ela autentica cada requisição e permite que o provedor registre o uso e aplique os limites da cota.
A chave nunca vai diretamente no script. Se o arquivo for compartilhado, publicado no GitHub ou enviado por e-mail, qualquer pessoa que o receba pode usar a sua cota e gerar cobranças na sua conta.
# Errado: a chave fica exposta no arquivo
chat <- chat_groq(api_key = "gsk_abc123xyz...")

# Certo: a chave fica em variável de ambiente
# O ellmer lê GROQ_API_KEY automaticamente
chat <- chat_groq()- O
.Renvironé um arquivo de texto lido pelo R na inicialização. Cada linha define uma variável de ambiente no formatoNOME=valor. Fica fora do projeto e é invisível para o Git e para qualquer compartilhamento de arquivo.
# Para abrir e editar o .Renviron do projeto:
usethis::edit_r_environ("project")

# Adicionar no arquivo que abrir (sem aspas):
# GROQ_API_KEY=sua-chave-groq
# GEMINI_API_KEY=sua-chave-gemini

# Depois reiniciar o R:
# Session > Restart R

# Para verificar se carregou:
Sys.getenv("GROQ_API_KEY")
# Retorna "" (vazio) se não encontrou
# Retorna a chave se encontrou
O objeto chat e o que ele representa
agente <- chat_groq(model = "openai/gpt-oss-120b")O objeto
agentenão é uma conexão aberta com o servidor.Ele não consome cota enquanto existe.
É um objeto R que armazena a configuração do provedor e do modelo, o system prompt, o histórico de todos os turnos da conversa e as tools registradas.
A conexão de rede só acontece quando você chama
$chat(). Cada chamada abre uma conexão, envia o contexto completo, recebe a resposta e fecha.
agente            # resumo: turnos, tokens, custo
agente$get_cost() # custo estimado em dólares até este momento
token_usage()     # total de tokens de todos os chats da sessão
O $ acessa métodos que pertencem especificamente a esse objeto. agente$chat() é diferente de uma função solta chat(), ela sabe qual histório carregar, qual provedor usar e quais tools estão registradas para esse agente específico.
Janela de contexto
O modelo não tem memória permanente entre chamadas.
A cada pergunta, o que ele recebe é um bloco único de texto contendo tudo que aconteceu na conversa até aquele ponto:
Pergunta 1: system_prompt + pergunta_1
Pergunta 2: system_prompt + pergunta_1 + resposta_1 + pergunta_2
Pergunta 3: system_prompt + pergunta_1 + resposta_1 +
            pergunta_2 + resposta_2 + pergunta_3
Esse bloco total tem um limite de tamanho medido em tokens, chamado janela de contexto. O gpt-oss-120b no Groq suporta 128 mil tokens. O granite4.2:3b local suporta 4 mil. Quando o limite é atingido, o modelo não consegue processar a requisição.
Consequências práticas:
- Conversas longas ficam mais caras a cada pergunta porque o histórico inteiro é reenviado
- Uma tool que devolve uma tabela grande pode consumir a janela rapidamente
- Para projetos com histórico longo, a estratégia é criar um novo objeto
chatpara conversas novas em vez de reutilizar o mesmo indefinidamente
System prompt
O system prompt é uma instrução fixa enviada ao modelo antes de qualquer mensagem do usuário.
- Define o papel, o tom e as regras do agente durante toda a conversa. É o principal mecanismo de controle do comportamento.
Eu percebi, ao construir o agente da Assimétrika, que system prompts bem estruturados seguem quatro elementos:
- Objetivo (o que o agente deve alcançar);
- Referência (as fontes de dados que ele deve consultar);
- Tarefa (as instruções de execução) e;
- Entrega (o formato e o tom da resposta).
system_prompt_agente <- "
Você é o assistente comercial da Assimétrika, consultoria de dados e IA.

Seu objetivo é apoiar o processo comercial, respondendo dúvidas sobre
preços e avaliando leads para orientar o próximo passo de venda, sem
nunca inventar uma informação que não esteja nas fontes disponíveis.

A referência para qualquer resposta sobre valor, prazo ou detalhe de
serviço é a tabela de preços. A referência para qualquer resposta sobre
prioridade, status ou follow-up é a base de leads. Ambas são consultadas
via tool, nunca preenchidas de memória.

Sua tarefa é consultar a fonte correspondente antes de responder, cruzar
as duas fontes quando a pergunta exigir, e recomendar um próximo passo
comercial sempre que fizer sentido.

A entrega deve ser em português, direta e objetiva, sem enrolação, sem
saudação de abertura nem despedida ao final, e em tópicos sempre que a
resposta envolver mais de um item.
"Editar o system prompt muda o comportamento do agente inteiro sem alterar nenhuma outra parte do código. É o lugar onde mais vale o tempo de ajuste e onde qualquer comportamento inesperado deve ser investigado primeiro.
Anatomia de um agente de IA - ESTUDE ISSO!
A imagem apresenta a estrutura de um Agente de Inteligência Artificial, mostrando como seus principais componentes trabalham de forma integrada para receber uma tarefa, tomar decisões, utilizar recursos externos e produzir uma resposta ou executar uma ação.
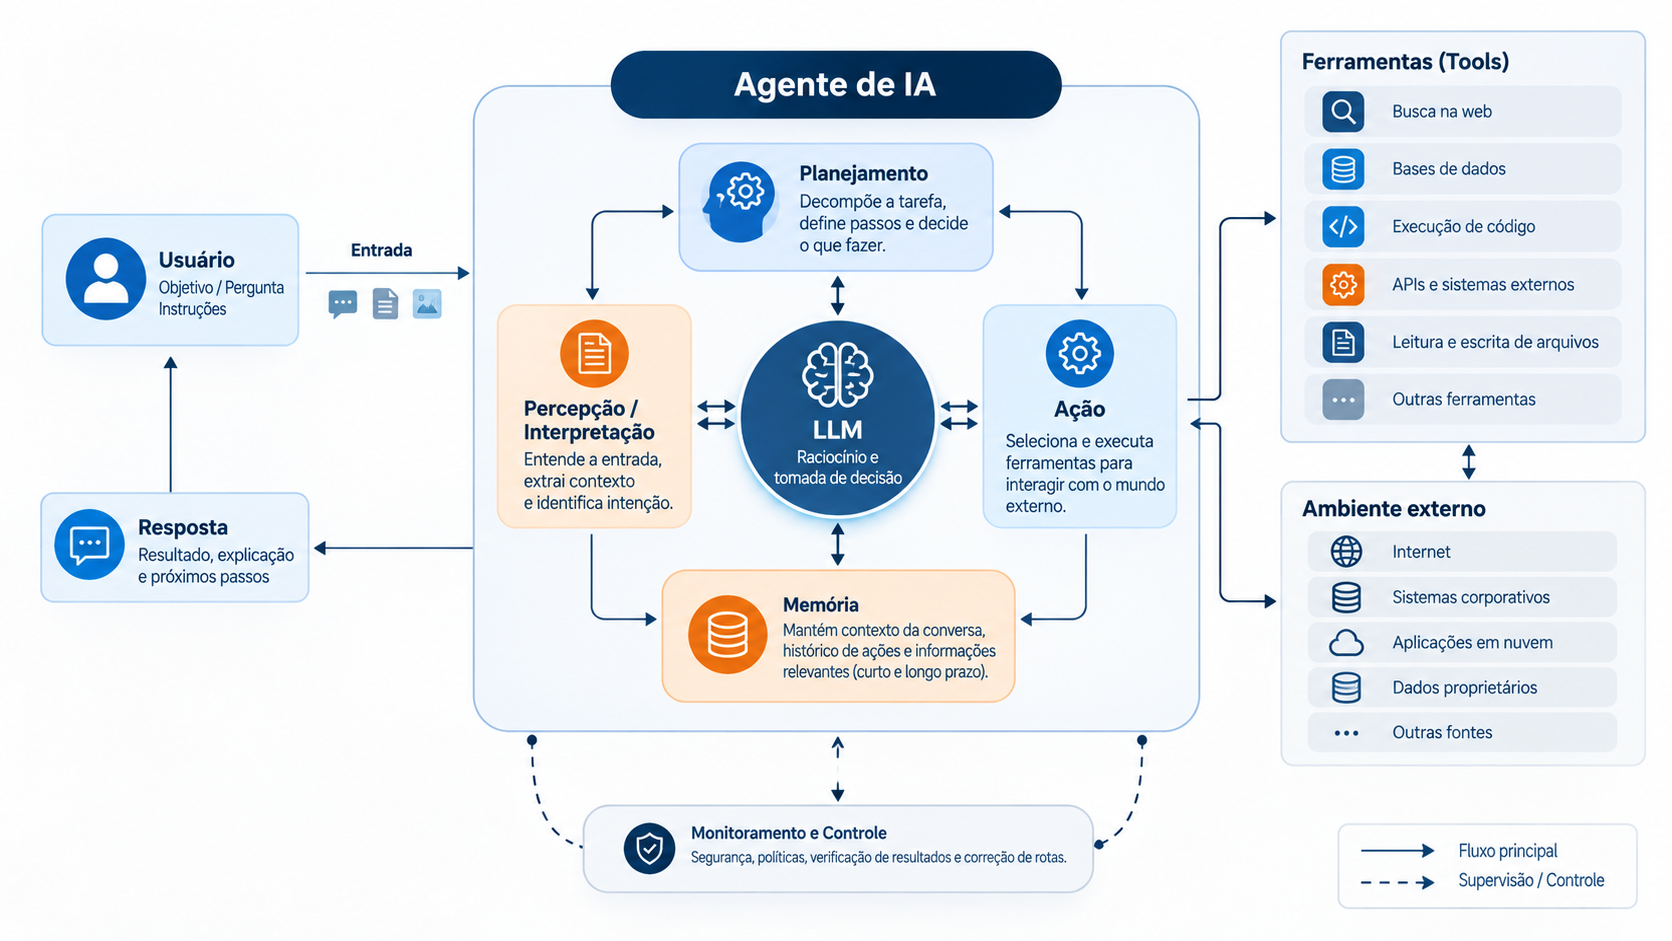
- O processo começa com a entrada do usuário, que pode ser uma pergunta, um objetivo, uma instrução, um contexto ou diferentes tipos de dados. Essas informações são interpretadas pelo agente para compreender o que precisa ser realizado.
- No centro está o Modelo de Linguagem (LLM), que funciona como um dos principais componentes de raciocínio e interpretação. Ele permite compreender informações em linguagem natural, analisar o contexto e auxiliar na tomada de decisões.
- O agente também possui uma camada de planejamento e raciocínio, responsável por decompor uma tarefa complexa em etapas menores, definir estratégias e decidir quais ações devem ser realizadas. Em vez de simplesmente responder a uma pergunta, o agente pode determinar uma sequência de ações para atingir o objetivo.
- Outro componente importante é a memória, que permite armazenar e recuperar informações relevantes. Ela pode manter o contexto da conversa, histórico de interações, resultados de ações anteriores ou conhecimentos necessários para a execução da tarefa.
- Quando precisa interagir com sistemas externos, o agente utiliza ferramentas (tools). Essas ferramentas podem incluir busca na web, APIs, bancos de dados, execução de código, leitura de arquivos e sistemas corporativos. Assim, o agente deixa de depender exclusivamente das informações disponíveis no modelo e consegue consultar dados, executar operações e interagir com outros sistemas.
- O agente também se relaciona com um ambiente externo, representado na imagem por elementos como Web, APIs, bases de dados e sistemas corporativos. A interação ocorre em um ciclo: o agente observa informações do ambiente, interpreta essas informações, planeja uma ação, utiliza uma ferramenta e observa novamente o resultado.
- Por fim, o agente produz uma saída, que pode ser uma resposta ao usuário, o resultado de uma tarefa, uma ação executada ou os próximos passos necessários.
Em resumo
A arquitetura pode ser entendida como um ciclo:
Entrada > Percepção > Raciocínio/Planejamento > Uso de Ferramentas > Ação > Observação > Memória > Nova decisão > Saída
A principal diferença entre um modelo de linguagem isolado e um agente de IA é justamente essa capacidade de combinar o modelo com memória, planejamento, ferramentas e interação com o ambiente, permitindo que o sistema não apenas gere uma resposta, mas também execute etapas para alcançar um objetivo.
Chat x agente
# Chat comum: responde com o que aprendeu no treinamento
# Sem acesso a dados externos, sem execução de funções
chat <- chat_groq(model = "openai/gpt-oss-120b")
chat$chat("Quanto custa uma consultoria de dados de 10 horas?")
# Retorna: faixa de mercado genérica, potencialmente inventada

# Agente: consulta a tabela de preços antes de responder
agente <- chat_groq(
  model         = "openai/gpt-oss-120b",
  system_prompt = system_prompt_agente,
  params        = params(temperature = 0.2))
agente$register_tool(consultar_precos)
agente$chat("Quanto custa uma consultoria de dados de 10 horas?")
# Retorna: o valor real da tabela de preços
A interface é idêntica nos dois casos. O que muda nesse caso é o que acontece antes da resposta chegar até vc.
Tool calling: o mecanismo central - ESTUDE ISSO!
Tool calling é o mecanismo pelo qual o modelo solicita a execução de uma função externa.
O modelo não executa código R diretamente. (Atenção aqui)
Ele emite uma instrução estruturada, o R executa a função e devolve o resultado como texto ao modelo, que então formula a resposta com base nesse dado verdadeiro.
O ciclo completo:
1. Você envia a pergunta
   agente$chat("Quanto custa 10 horas de consultoria?")

2. O modelo recebe:
   system_prompt + descrição das tools + pergunta

3. O modelo decide: essa pergunta requer a tool?
   Sim: devolve uma instrução de chamada, não uma resposta
   {"tool": "consultar_precos", "arguments": {}}

4. O R intercepta e executa a função
   resultado <- consultar_precos()

5. O resultado volta ao modelo como contexto adicional
   "[{"servico":"Consultoria de dados","preco_brl":250,...}]"

6. O modelo formula a resposta com base no dado real
   "Uma consultoria de dados de 10 horas custa R$ 2.500..."
Construindo a primeira tool
Uma tool tem duas partes:
- Uma função R que executa a ação;
- E uma descrição em texto que o modelo lê para decidir quando chamá-la.
tabela_precos <- read.csv("precos.csv", stringsAsFactors = FALSE)

consultar_precos <- tool(
  function() {
    toJSON(tabela_precos, auto_unbox = TRUE)
  },
  name        = "consultar_precos",
  description = "Consulta a tabela de preços dos serviços oferecidos,
  incluindo valor em BRL, unidade de cobrança, prazo de entrega,
  perfil do cliente ideal e percentual de desconto para pacotes.")

agente$register_tool(consultar_precos)
Por que
name = "consultar_precos": sem um nome explícito, oellmergera um nome automático que pode colidir com o de outra tool registrada no mesmo agente, fazendo uma substituir a outra silenciosamente. Nomear explicitamente evita esse problema.Por que
toJSON()comauto_unbox = TRUE: o modelo recebe texto. O JSON é o formato que os modelos processam com mais precisão. O argumentoauto_unbox = TRUEevita que valores únicos virem listas JSON desnecessariamente, o que poderia confundir o modelo na interpretação do resultado.Por que a descrição importa MUITO: o modelo lê a descrição para decidir quando chamar a função. Uma descrição vaga como “consulta dados” produz decisões erradas. Uma descrição precisa, informando o conteúdo exato da tabela, direciona o modelo para a fonte certa.
# Testando a primeira tool:
agente$chat("Quanto custa uma consultoria de dados de 10 horas?")
agente$chat("Qual serviço tem o prazo de entrega mais rápido?")
agente$chat("Se eu fechar análise de dados e dashboard juntos, tem desconto?")
Quando o log mostra ● tool call: consultar_precos() seguido de ● tool result: e depois ○ resposta, o ciclo funcionou corretamente. O símbolo ● indica execução da tool; o ○ indica a resposta final do modelo.
Segunda tool e cruzamento de dados
Um agente pode ter mais de uma tool registrada. O modelo decide, a partir da descrição de cada uma, qual chamar para cada pergunta. Nenhuma instrução explícita é necessária.
tabela_leads <- read.csv("leads.csv", stringsAsFactors = FALSE)

consultar_leads <- tool(
  function() {
    toJSON(tabela_leads, auto_unbox = TRUE)
  },
  name        = "consultar_leads",
  description = "Consulta a base de leads e contatos comerciais,
  incluindo nome, empresa, serviço de interesse, status atual,
  prioridade e valor potencial do negócio em BRL.")

agente$register_tool(consultar_leads)

# Pergunta que usa apenas a tool de leads:
agente$chat("Quais leads devo priorizar essa semana?")

# Pergunta que exige as duas tools na mesma resposta:
agente$chat("A Marina Costa perguntou sobre automação com IA.
             Quanto cobrar e ela está entre as prioridades atuais?")

# Cálculo que cruza as duas tabelas:
agente$chat("Some o valor potencial de todos os leads com status em negociação. Qual o total em aberto?")
RAG x tool calling - ASSUNTO QUENTE!
Pessoal, uma dúvida que aparece com frequência é quando usar RAG e quando usar tool calling. As duas técnicas resolvem o problema de dar ao modelo acesso a informação externa, mas de formas diferentes.
- RAG (Retrieval-Augmented Generation) busca trechos relevantes dentro de documentos por similaridade semântica e os injeta no contexto antes da resposta:
Pergunta > busca semântica em PDFs > trecho relevante > modelo > resposta- Tool calling executa uma ação ou consulta pontual em tempo real:
Pergunta > modelo decide chamar função > R executa > resultado > modelo > resposta| Critério | RAG | Tool calling |
|---|---|---|
| Fonte dos dados | Documentos longos, PDFs, manuais | Tabelas, APIs, cálculos em tempo real |
| Como acessa | Busca por similaridade antes da resposta | Execução de função durante a resposta |
| Melhor para | Bases de conhecimento estáticas | Dados que mudam, consultas pontuais |
| No ellmer | ragnar + ellmer |
tool() + $register_tool() |
As duas técnicas são complementares.
Eu usei tool calling no projeto da Assimétrika porque as fontes eram tabelas estruturadas com dados que precisam estar sempre atualizados.
Para um projeto que consultasse um acervo de contratos em PDF, a escolha seria RAG.
Memória entre sessões
O objeto agente mantém o histórico apenas enquanto existir nesta sessão do R. Quando o R é fechado, o objeto desaparece e o histórico é perdido.
agente_novo <- chat_groq(
  model         = "openai/gpt-oss-120b",
  system_prompt = system_prompt_agente)

agente_novo$register_tool(consultar_precos)
agente_novo$register_tool(consultar_leads)

agente_novo$chat("O que você acabou de me dizer sobre a Marina Costa?")
# O agente_novo não tem esse histórico.
# A conversa sobre a Marina Costa aconteceu com outro objeto.- Se o objetivo é que o agente lembre algo entre sessões, essa informação precisa estar salva em algum lugar fora da memória do R.
Memória persistente com get_turns() e set_turns()
dir.create("conversas", showWarnings = FALSE)

# Salvar o histórico em disco:
turnos <- agente$get_turns()
saveRDS(turnos, "conversas/usuario_123.rds")

# Numa sessão nova, recuperar e aplicar:
agente_restaurado <- chat_groq(
  model         = "openai/gpt-oss-120b",
  system_prompt = system_prompt_agente)

agente_restaurado$register_tool(consultar_precos)
agente_restaurado$register_tool(consultar_leads)

turnos_salvos <- readRDS("conversas/usuario_123.rds")
agente_restaurado$set_turns(turnos_salvos)

agente_restaurado$chat("O que conversamos sobre a Marina Costa?")Para produção com múltiplos usuários, a mesma lógica de get_turns() e set_turns() se aplica, substituindo o arquivo .rds por um banco de dados como PostgreSQL.
Cada usuário tem um identificador único, e o histórico é carregado no início da sessão e salvo ao final.
Trocando de provedor
Eu percebi, ao testar os três provedores no mesmo projeto, que o comportamento varia mais do que se espera para o mesmo system prompt e as mesmas tools.
Modelos diferentes foram treinados com dados diferentes e com objetivos diferentes.
O importante é usar o mesmo system prompt ao comparar, para que a comparação seja justa.
system_prompt_base <- "Você é um assistente comercial da Assimétrika.
Consulte as tabelas antes de responder. Nunca informe um preço ou
dado de lead sem consultá-las. Responda em português."

# Groq:
agente_groq <- chat_groq(
  model         = "openai/gpt-oss-120b",
  system_prompt = system_prompt_base,
  params        = params(temperature = 0.2))

agente_groq$register_tool(consultar_precos)
agente_groq$register_tool(consultar_leads)

# Google Gemini:
agente_gemini <- chat_google_gemini(
  model         = "gemini-flash-lite-latest",
  system_prompt = system_prompt_base,
  params        = params(temperature = 0.2))

agente_gemini$register_tool(consultar_precos)
agente_gemini$register_tool(consultar_leads)

# Mesma pergunta, provedores diferentes:
agente_groq$chat("Quanto custa uma consultoria de dados de 10 horas?")
agente_gemini$chat("Quanto custa uma consultoria de dados de 10 horas?")
Nuvem x local
Quando você usa Groq ou Gemini via API, os dados que você envia trafegam pelos servidores do provedor.
Para dados sensíveis de clientes, contratos ou informações financeiras, a alternativa é o Ollama: um runtime que executa modelos localmente, sem internet e sem custo por requisição.
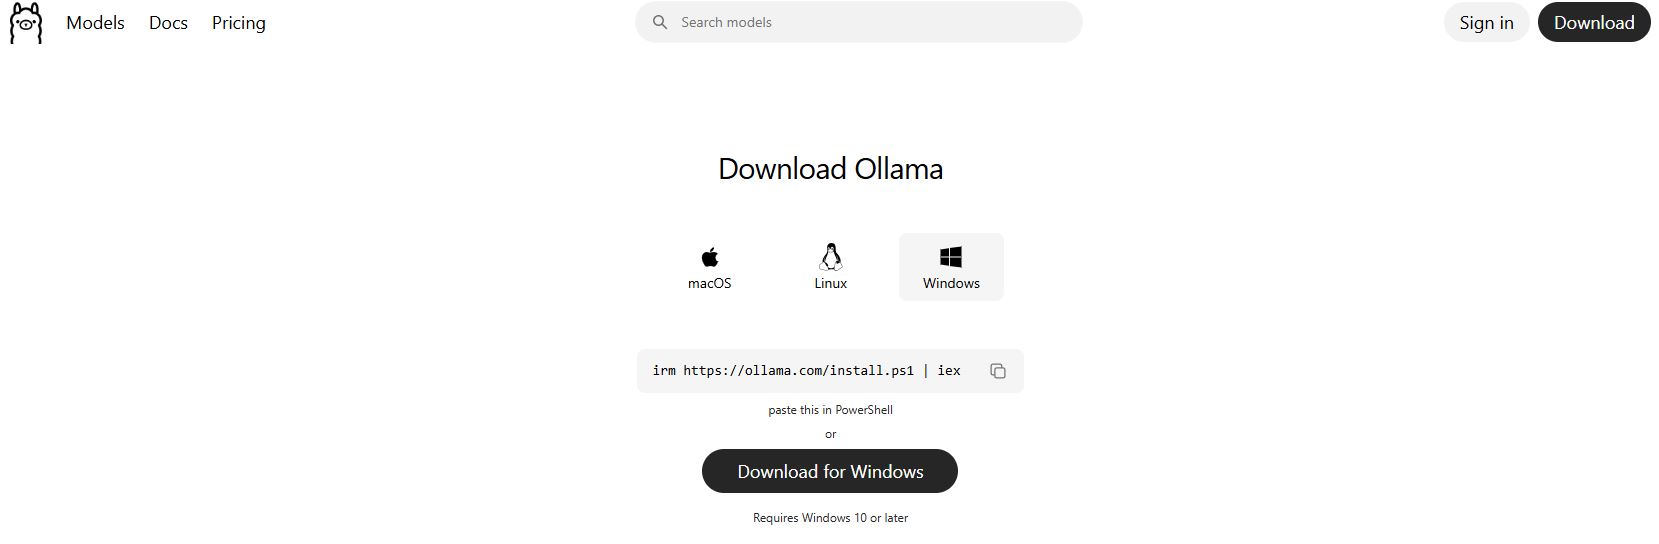
Baixe o ollama e escolha o modelo local
- Baixe o ollama no site.
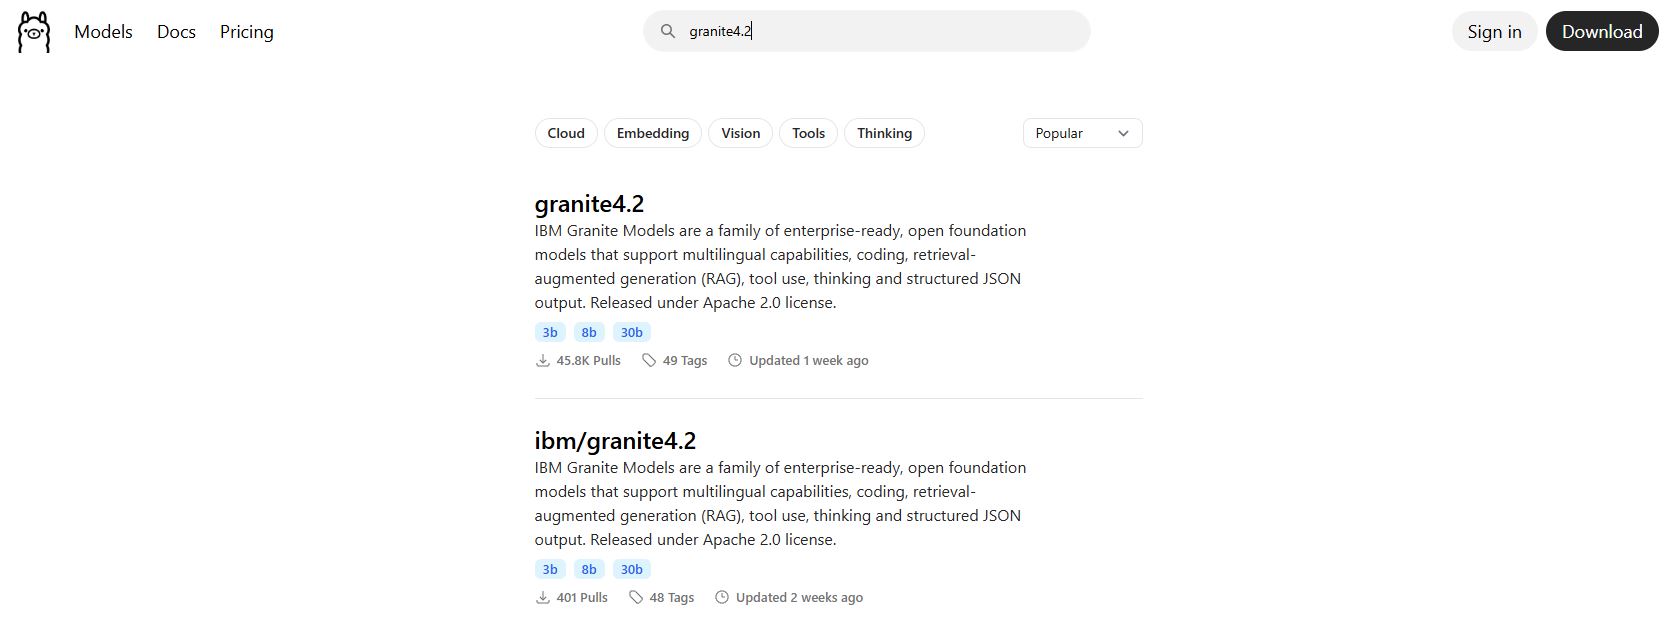
- Escolha o modelo que você vai utilizar.
- Abra o CMD no seu computador e digite e rode o modelo escolhido:
ollama run granite4.2:3b- Faça uma pergunta e teste se está funcionando.
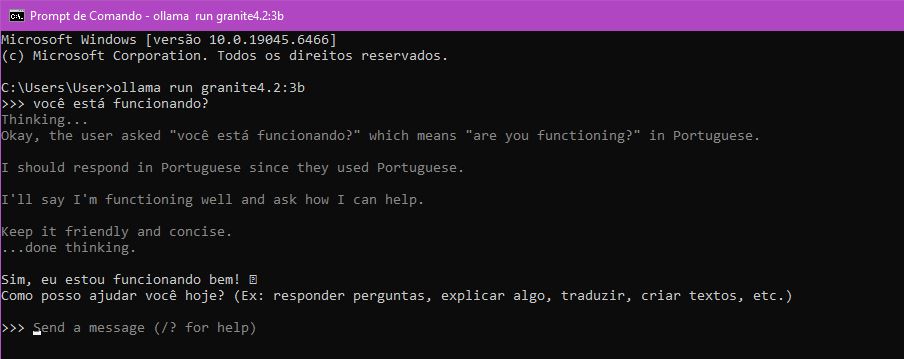
# Requer o Ollama instalado (ollama.ai) e o modelo baixado:
# ollama pull granite4.2:3b

agente_local <- chat_ollama(
  model         = "granite4.2:3b",
  system_prompt = system_prompt_base,
  params        = params(think = FALSE))

agente_local$register_tool(consultar_precos)
agente_local$register_tool(consultar_leads)

agente_local$chat("Quanto custa uma consultoria de dados de 10 horas?")- O argumento
think = FALSEdesativa o modo de raciocínio interno dogranite4.2:3b, que aumenta a latência sem ganho perceptível para consultas simples.
| Característica | Nuvem (Groq, Gemini) | Local (Ollama) |
|---|---|---|
| Velocidade | quase instantânea | depende do hardware |
| Privacidade | dado sai da máquina | dado fica local |
| Custo | por token | zero |
| Internet | obrigatória | não necessária |
| Modelos disponíveis | grandes e potentes | limitado ao hardware |
| Setup | chave de API | instalar Ollama + baixar modelo |
Ética, viés e LGPD
PESSOAL ….
Modelos de linguagem foram treinados com texto produzido por humanos.
Os preconceitos presentes nesses textos entram no modelo e podem ser amplificados nas respostas.
Casos documentados incluem sistemas de reconhecimento facial com taxas de erro significativamente maiores em pessoas negras e mulheres, modelos de triagem de currículos que penalizavam nomes estatisticamente associados a minorias, e modelos de análise de crédito que reproduziam desigualdades históricas de acesso.
A responsabilidade jurídica e ética pelo comportamento do agente é de quem o constrói. Um agente que responde perguntas sobre preços tem perfil de risco diferente de um que toma decisões sobre contratação ou concessão de crédito.
- Mesmo assim, o princípio se aplica em testar sistematicamente os casos de borda e auditar os resultados antes de colocar em produção.
LGPD e dados enviados via API: quando você usa Groq ou Gemini, os dados que você envia trafegam por servidores internacionais.
A Lei Geral de Proteção de Dados exige que o titular dos dados saiba e concorde com o destino dos seus dados.
Enviar dados pessoais de clientes para uma API sem previsão na política de privacidade configura infração.
| Tipo de dado | Nível de risco | Recomendação |
|---|---|---|
| Dados anonimizados | Baixo | Seguro para nuvem |
| Nome e e-mail de leads | Médio | Avaliar política de privacidade |
| Dados financeiros de clientes | Alto | Usar Ollama local |
| Dados de saúde e biometria | Crítico | Nunca enviar para nuvem |
Boas práticas
- Humano no loop: decisões que afetam pessoas, como concessão de crédito, triagem de candidatos ou diagnósticos médicos, não devem ser tomadas pelo agente sem revisão humana. O agente atua como assistente analítico; a palavra final deve ser de um profissional.
- Transparência: quando uma resposta foi gerada por IA, informe. Não apresente saída de modelo como análise humana.
- Testar casos de borda antes de produção: o que o agente faz quando a pergunta está fora do escopo das tools? O que acontece se a tabela retornar um valor nulo ou um erro? O agente recusa perguntas inadequadas?
- Manter o system prompt revisado: o comportamento do agente é um reflexo direto das instruções que você escreveu. Diante de qualquer resposta inesperada, o primeiro ponto de auditoria é o system prompt.
Conversa contínua
live_console(agente)live_console() abre uma sessão interativa no console do R. Em vez de reescrever agente$chat() a cada mensagem, você digita diretamente e recebe a resposta no mesmo terminal. O histórico é mantido entre as mensagens. Esc encerra a sessão.
Glossário
API (Application Programming Interface): interface padronizada para comunicação entre sistemas. Via API, o R envia uma requisição HTTP com o texto da pergunta e recebe a resposta como JSON.
Alucinação: comportamento em que o modelo gera informação factualmente incorreta com o mesmo nível de confiança com que gera informação correta. Consequência do mecanismo de predição de tokens.
Deep Learning: subárea do Machine Learning que usa redes neurais profundas para aprender representações hierárquicas dos dados.
Destilação de conhecimento: técnica de treinamento em que o conhecimento de um modelo maior é transferido para um modelo menor, preservando capacidade com ganho em eficiência.
Fine-tuning: etapa de treinamento em que o modelo é ajustado com exemplos de conversas de alta qualidade para aprender a responder perguntas em vez de apenas completar texto.
IA Generativa: categoria de IA que produz conteúdo novo: texto, imagem, áudio, código, vídeo.
Janela de contexto: limite máximo de tokens que o modelo processa em uma única chamada. Inclui system prompt, histórico completo e resultados das tools.
JSON (JavaScript Object Notation): formato de texto para representar dados estruturados. Padrão de troca entre sistemas, incluindo APIs de IA.
LLM (Large Language Model): modelo de linguagem treinado em volumes massivos de texto. Gera respostas prevendo o token mais provável dado o contexto anterior.
Machine Learning: subárea da IA em que sistemas aprendem padrões a partir de dados sem serem explicitamente programados para cada tarefa.
MoE (Mixture of Experts): arquitetura em que o modelo é dividido em blocos especialistas e ativa apenas um subconjunto por token gerado. Permite capacidade de modelos grandes com custo de modelos menores.
Parâmetros: valores numéricos internos ajustados durante o treinamento para representar padrões da linguagem.
RAG (Retrieval-Augmented Generation): técnica que busca trechos relevantes em documentos por similaridade semântica e os injeta no contexto antes da resposta.
RLHF (Reinforcement Learning from Human Feedback): etapa de treinamento em que avaliadores humanos classificam respostas. O modelo aprende a preferir o que os humanos consideram útil e seguro.
System prompt: instrução fixa enviada ao modelo antes de qualquer mensagem do usuário. Define papel, tom e regras durante toda a conversa.
Temperatura: parâmetro que controla a aleatoriedade na seleção do próximo token. Valores baixos produzem respostas consistentes; valores altos produzem variação.
Token: unidade de processamento dos LLMs. Fragmento de texto reconhecido durante o treinamento. Em português, equivale a aproximadamente 3 a 4 caracteres.
Tool calling: mecanismo pelo qual o modelo solicita a execução de uma função externa. O modelo emite uma instrução estruturada, o R executa e devolve o resultado como texto.
Fechando o ciclo até aqui
Pessoal, o que construímos aqui cobre o caminho completo, e não tem GRANDE MISTÉRIO, como os GURUS da IA dizem…
Fomos do conceito de inteligência até um agente em produção consultando dados verdadeiros de um negócio.
O que mudará para o seu projeto?
É o que você conecta ao agente.
Pode ser uma tabela de clientes, um relatório mensal, um banco de dados de Postgres, uma API externa.
O mecanismo é o mesmo, você escreve a função R, define a descrição, registra com
$register_tool(), e o modelo decide quando e como usar.
Próximos passos
Se você chegou até aqui e quer evoluir, o caminho natural é este:
1. Saída estruturada com chat_structured()
Em vez de receber texto livre, você define um esquema de dados e o modelo preenche esse esquema. Útil quando você quer que o agente extraia informações de um texto e devolva um data.frame pronto para análise, sem precisar parsear a resposta manualmente.
library(ellmer)

schema <- type_object(
  servico    = type_string("Nome do serviço mencionado"),
  valor      = type_number("Valor em BRL, se mencionado"),
  prioridade = type_string("Alta, Média ou Baixa"))

resultado <- chat$extract_data(
  "O cliente perguntou sobre consultoria de dados e parece urgente.",
  type = schema)
2. Entrada multimodal com content_image_file() e content_pdf_file()
Modelos como Gemini e Claude aceitam imagens e PDFs como parte da pergunta. Você pode enviar um contrato em PDF e pedir um resumo, ou enviar um gráfico e pedir interpretação dos dados.
resposta <- chat$chat(
  content_pdf_file("contrato_cliente.pdf"),
  "Quais são as cláusulas de rescisão deste contrato?")
3. Tool com argumento
Em vez de devolver a tabela inteira, a tool recebe o nome do serviço e retorna só a linha correspondente. O modelo decide o que passar como argumento. Reduz tokens e torna a resposta mais precisa.
consultar_preco_servico <- tool(
  function(servico) {
    linha <- tabela_precos[
      grepl(servico, tabela_precos$servico, ignore.case = TRUE), ]
    toJSON(linha, auto_unbox = TRUE)
  },
  name        = "consultar_preco_servico",
  description = "Consulta o preço de um serviço específico pelo nome.",
  servico     = type_string("Nome do serviço a consultar"))
4. RAG com ragnar
Quando a fonte de dados são documentos longos em vez de tabelas, o ragnar faz a busca semântica e o ellmer usa o resultado como contexto. A combinação resolve o problema de bases de conhecimento que não cabem na janela de contexto.
5. Interface com shinychat
O shinychat transforma o agente em uma interface de chat publicável no shinyapps.io. Cada sessão cria um agente próprio com histórico isolado. É o próximo passo natural para quem quer que outras pessoas usem o agente sem abrir o R.
6. Memória com banco de dados
Substituir o .rds por PostgreSQL via DBI e RPostgres. Cada usuário tem um identificador, e o histórico é carregado no início da sessão e salvo ao final. É o que separa um protótipo de uma ferramenta que a equipe usa todo dia.
Pacotes e referências
- ellmer: ellmer.tidyverse.org
- jsonlite: cran.r-project.org/web/packages/jsonlite
- shinychat: posit-dev.github.io/shinychat
- ragnar: tidyverse.github.io/ragnar
- Groq Console: console.groq.com
- Google AI Studio: aistudio.google.com
- Ollama: ollama.ai
Artigos internet
What is retrieval augmented generation (RAG).
O que é tool calling? Um guia completo para integração de IA
Function Calling vs Tool Use in LLMs: Mechanics of JSON Schema and Its Connection to RAG
Artigos Revistas acadêmicas
The Evolution of Tool Use in LLM Agents: From Single-Tool Call to Multi-Tool Orchestration